Принципы индексации текста через Google Cloud NLP
Сдвиг, произошедший в ранжировании магазина приложений, ознаменовал окончательный переход от точного совпадения ключевых слов к семантическому пониманию запроса. Поисковая система обрабатывает намерение пользователя, а не просто ищет строку символов в метаданных. Это прямое следствие глубокой интеграции нейросетей семейства Gemini в экосистему платформы: пользователь описывает задачу в свободной форме, а система самостоятельно подбирает релевантные продукты на основе контекста.
Практически это меняет приоритеты специалиста по продвижению. Ключевые слова по-прежнему необходимы, но критическое значение приобрел контекст вокруг них. Алгоритм оценивает, насколько связно сущности в тексте соответствуют заявленной тематике. Повторение одного и того же запроса пять раз в разных падежах больше не дает прироста позиций, зато многократно увеличивает риск пессимизации за переспам.
Механизм работы поисковых нейросетей при обработке длинных запросов (long-tail) базируется на векторном представлении интента. Система анализирует не точное совпадение фразы, а обрезает префиксы и добавляет контекстные термины из истории поиска пользователя. Нейросеть сопоставляет полученный вектор с графом знаний магазина, определяя релевантность продукта без привязки к прямому вхождению слов.
Новые стратегии строятся вокруг интентных низкочастотных запросов, глубоких локализаций под узкие сегменты аудитории и использования кастомных страниц CSL. Актуальная информация о факторах ранжирования в Google Play доказывает, что вес текстовых полей распределяется неравномерно: название и краткое описание дают наибольший вклад в поисковую видимость, тогда как полный текст усиливает тематическую релевантность. Изучая тренды 2026 года, можно с уверенностью сказать, что будущее оптимизации и новые подходы в ASO требуют создания структурированного контента, понятного машинному интеллекту.
Правила оптимизации Long Description без переспама
Базовое правило при написании текста — одновременно работать на два типа анализаторов: облачный алгоритм, который разберет контент на сущности, и живого пользователя, принимающего решение об установке за несколько секунд. Эти цели абсолютно комплементарны. Структурированный, конкретный материал с понятной логикой одинаково эффективно обрабатывается машиной и воспринимается человеком.
Интент и конверсия короткого текста
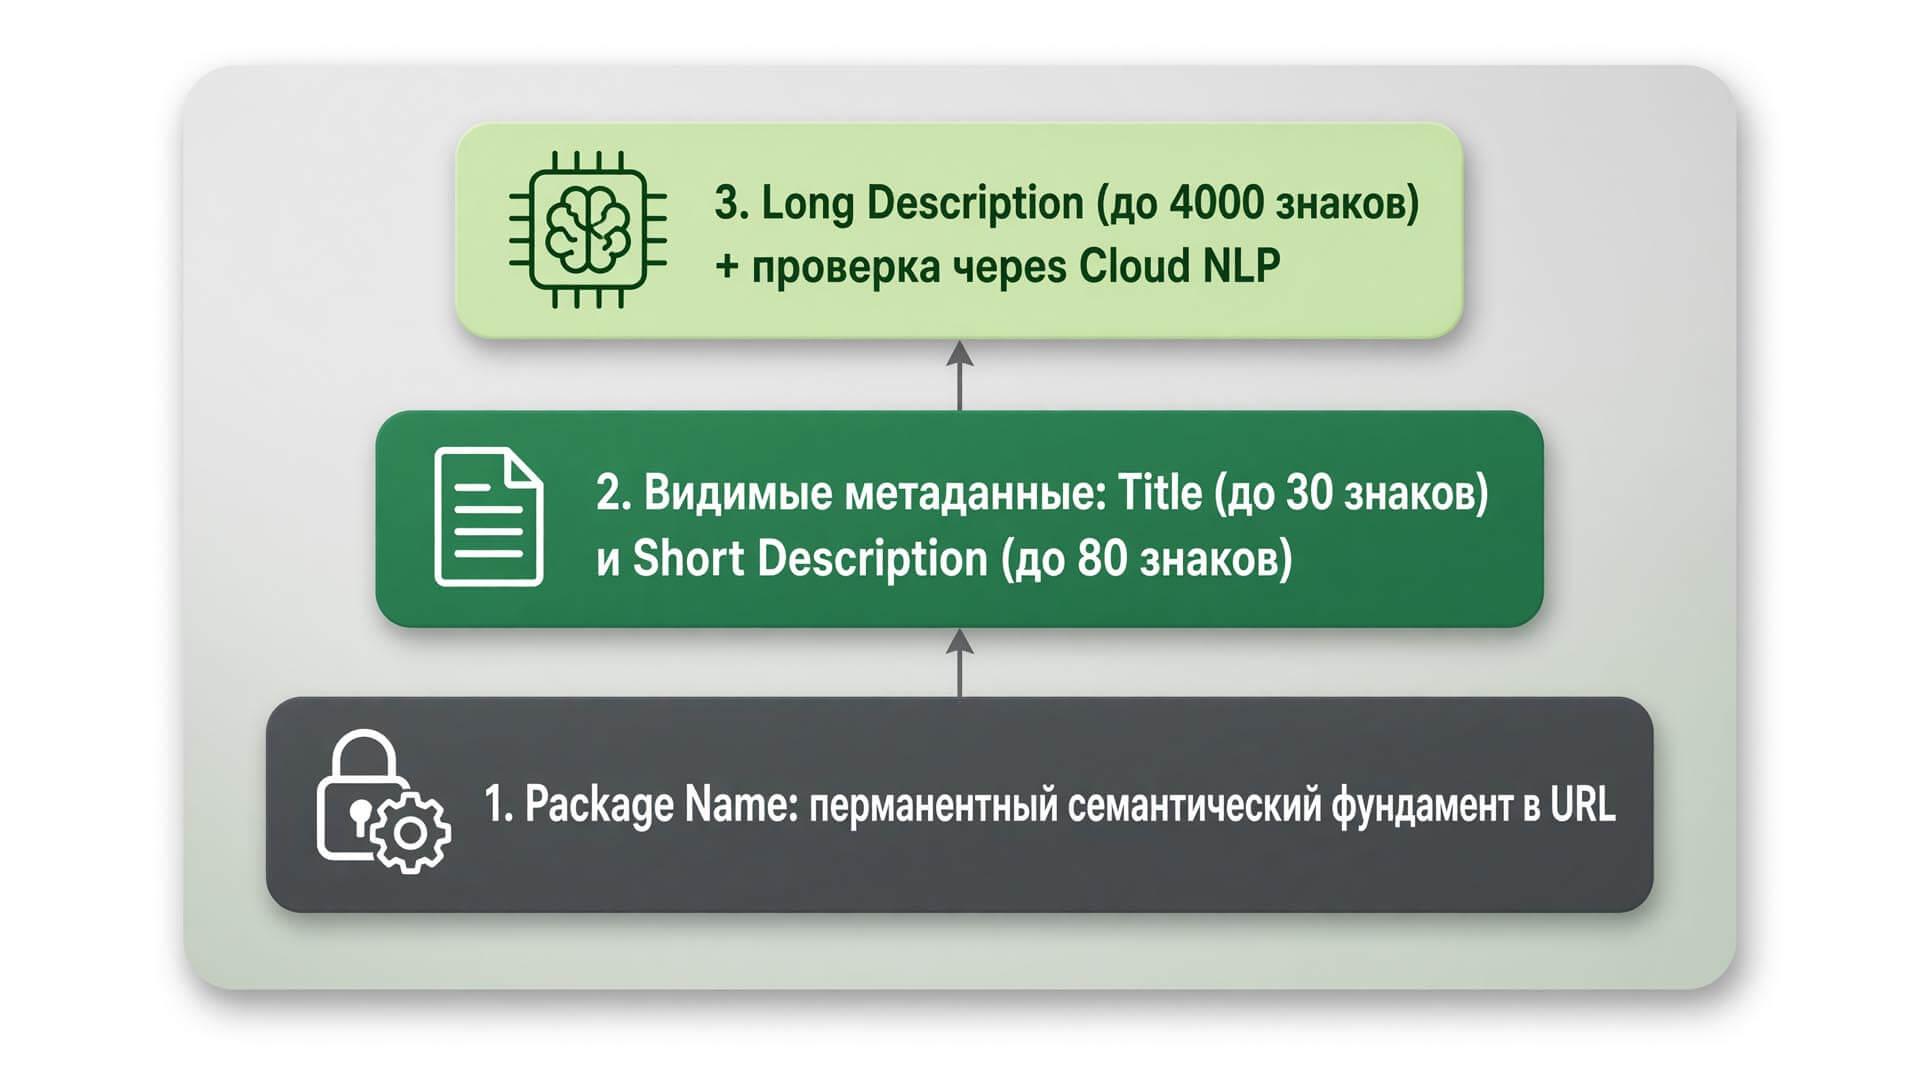
Краткое описание ограничено 80 символами, которые видны в карточке до раскрытия полного полотна текста. Данное поле индексируется и напрямую определяет поисковую видимость. Задача маркетолога сводится к интеграции одного высокочастотного ключа и четкого уникального торгового предложения (УТП). Абстракции и маркетинговые слоганы снижают конверсию.
Рабочая формула строится по строгим схемам: действие плюс выгода, проблема плюс решение, либо измеримый результат плюс призыв к действию. Конкретика и цифры дают кратно большую конверсию в установку по сравнению с размытыми обещаниями.
| Параметр | Плохое описание | Хорошее описание |
|---|---|---|
| Наличие УТП | «Лучшее приложение для всего! Топ-1, бесплатно, без рекламы, куча функций!» | «Заметки и списки задач без рекламы — быстро создавайте списки и синхронизируйте данные.» |
| Использование ключа | Ключ потерян среди маркетинговых штампов, зафиксирован переспам | Ключ органично встроен в конкретный сценарий использования продукта |
| Конверсионность | Низкая: нет понятной ценности, отсутствует мотивация к установке | Высокая: назначение и ключевая выгода считываются с первого прочтения |
Структура и плотность семантики
Полный текст вмещает до 4000 символов. Консоль разработчика поддерживает базовое HTML-форматирование: теги для выделения жирным шрифтом, переносы строк, а также маркированные списки. Подзаголовки структурируют полотно и помогают алгоритму безошибочно выделять тематические блоки.
Распределение ключевых слов подчиняется математической логике MMR (Maximal Marginal Relevance). Данный алгоритм жадного отбора подразумевает, что каждый новый абзац раскрывает отдельный аспект функциональности и обладает минимальной семантической похожестью на предыдущие блоки. Сначала собирается ядро запросов, затем вычисляется косинусное сходство эмбеддингов. На каждом шаге выбирается элемент, максимизирующий баланс релевантности и новизны. Первый абзац содержит главный ключ, последующие — смежные функции и выгоды. Это расширяет охват и исключает дублирование.
Интеграция графа знаний в контент
Поисковая система связывает данные из карточки продукта с глобальным графом знаний через процесс NER (Named Entity Recognition). Алгоритм выделяет объекты и их связи в виде триплетов: субъект, отношение, объект. Затем эти сущности сопоставляются с уже известными узлами графа. Чем точнее описана предметная область, тем увереннее система присваивает продукту нужную категорию.
Стандартизация терминов играет решающую роль. Единообразные названия свойств упрощают распознавание. Продукт для фитнеса обязан содержать термины «тренировка», «прогресс», «подход» — это сущности, которые машина умеет однозначно классифицировать. Рядом с ними располагаются атрибуты, объясняющие контекст использования.
Работа с текстом требует точной классификации продукта алгоритмом. Если каждый абзац покрывает отдельный аспект функциональности и использует термины ниши, система правильно соотносит карточку с поисковыми запросами целевой аудитории.
Попадание в тематические подборки магазина напрямую зависит от плотности покрытия кластера сущностей. Оптимизация описания приложения в «Гугл плей» требует внедрения лучших практик семантического копирайтинга. Главные советы по описанию сводятся к конкретике: раскрывайте функции через связанные термины. Понимая, как писать описание приложения для Google Play, специалист создает текст, который одновременно ранжируется машиной и конвертирует пользователя.
Проверка описания в NLP API и типичные ошибки
Облачный интерфейс Natural Language API позволяет проанализировать текст в точности так, как его обрабатывает поисковый робот. Сервис разбирает предложения на составные части, присваивает объектам показатель значимости и классифицирует содержимое по категориям. Для специалиста это единственный объективный способ верифицировать качество контента.
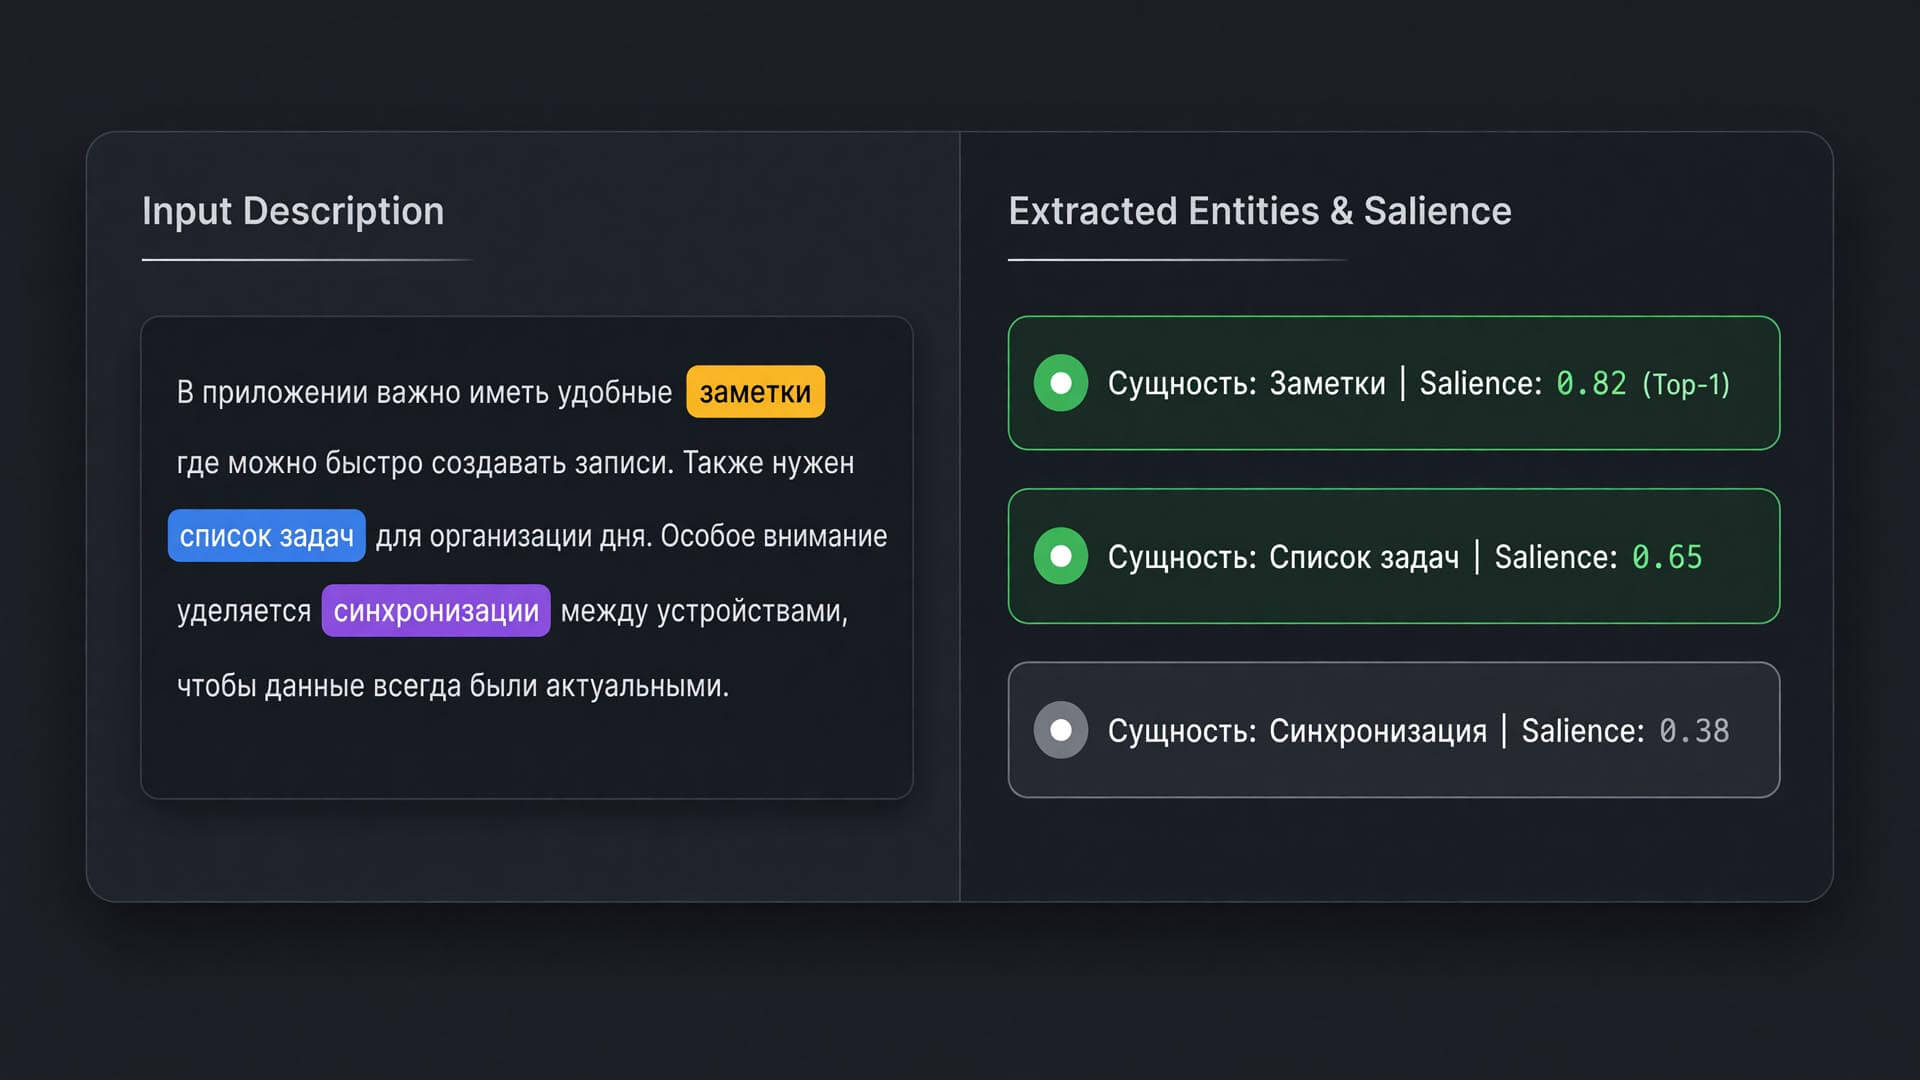
Для начала работы необходимо создать проект в облачной консоли, активировать API командой через терминал и настроить аутентификацию посредством JSON-ключа сервисного аккаунта. Текст передается в запросе analyzeEntities с указанием кодировки UTF-8. Платформа предоставляет лимит до пяти тысяч бесплатных запросов в месяц, чего достаточно для регулярного аудита.
Как алгоритм выделяет сущности и тематику
В контексте машинного обучения Entity Recognition — процесс автоматического извлечения из массива данных именованных объектов, продуктов, действий и концепций с определением их семантического типа.
Система вычленяет из сплошного массива объекты, классифицирует их по типам (например, CONSUMER_GOOD или OTHER) и оценивает их вес. Существительные всегда обладают большим весом, чем прилагательные. Термин «планировщик» распознается как значимая сущность, тогда как слова «быстрый» или «удобный» выступают лишь второстепенными атрибутами без самостоятельной ценности.
В ответе сервера присутствует массив mentions, показывающий количество упоминаний объекта и его грамматическую роль. Позиция слова в предложении критически влияет на итоговую оценку его важности для всего документа.
Методики повышения семантического веса
Salience Score — числовой показатель значимости сущности в документе в диапазоне от нуля до единицы, отражающий степень ее важности для общего контекста.
Существует четыре доказанные методики повышения данного показателя для целевых запросов:
- Размещение в первом абзаце: объекты, упомянутые в начальных 20% текста, получают максимальный приоритет при индексации.
- Использование в роли подлежащего: конструирование предложений, где ключевое слово выполнит действие, дает сильный сигнал алгоритму.
- Равномерное распределение: пять или семь органичных повторений по разным секциям усиливают вес, тогда как скопление в одном абзаце вызывает фильтрацию.
- Обогащение контекстом: наличие связанных терминов и атрибутов вокруг главного слова подтверждает тематическую достоверность.
Практический анализ описания приложения nlp в Google Play сводится к проверке топ-3 сущностей по показателю значимости. Если главный запрос уступает второстепенным словам, структура требует переработки. Обработка естественного языка и семантический анализ превращают субъективную оценку текста в точный математический процесс, где инструменты NLP выступают главным мерилом качества.
Package Name как скрытый фактор ранжирования в URL
Идентификатор приложения (Application ID) формирует итоговый URL-адрес страницы в магазине. Данный параметр индексируется поисковыми роботами и выступает вспомогательным, но абсолютно перманентным фактором ранжирования. Слово, интегрированное в этот идентификатор, работает на привлечение трафика на протяжении всего жизненного цикла продукта.
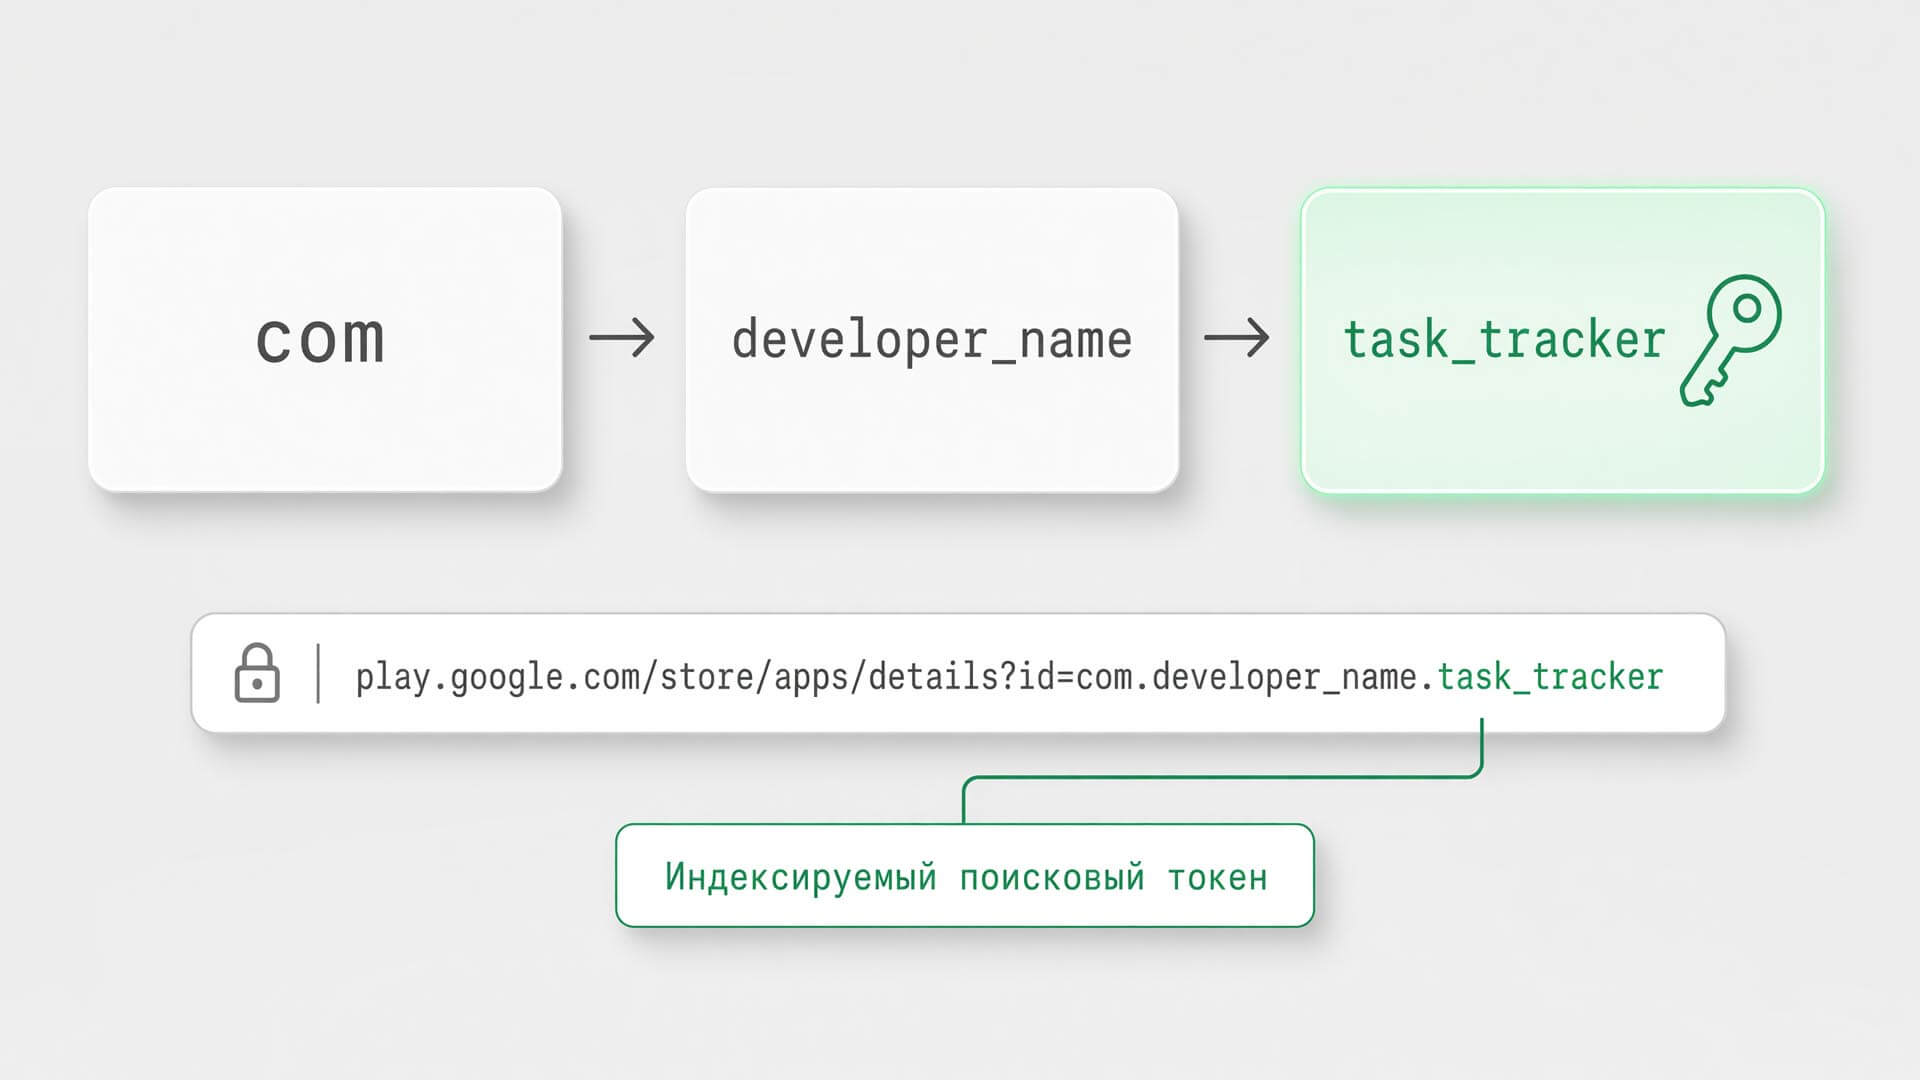
Техническая структура строится по строгой иерархии: доменная зона, имя разработчика, ключевой запрос. Третий сегмент идеально подходит для внедрения одного высокочастотного термина, релевантного категории. Длинные составные конструкции из нескольких слов размывают фокус и не приносят дополнительной пользы.
Техническая архитектура платформы устроена так, что идентификатор задается исключительно один раз при инициализации проекта. Изменить его после релиза технически невозможно. Попытка смены приведет к необходимости публикации совершенно нового продукта, что означает полную потерю накопленной базы пользователей, отзывов и исторических позиций в поиске.
Грамотная оптимизация package name в Google Play требует проведения исследований до написания первой строчки кода. Выбор package name для Android-приложения должен опираться на ядро запросов, исключая дублирование этого же слова в названии продукта. Лучшие практики и рекомендации сводятся к использованию короткого, емкого термина, отражающего суть сервиса.
Влияние поведенческих факторов на текстовое ранжирование
Текстовая релевантность работает исключительно в связке с конверсионными элементами. Идеально составленный контент не способен удержать позиции, если визуальная подача не привлекает аудиторию. Влияние технического состояния в Android Vitals и метрик удержания доказывает, что алгоритм оценивает качество пользовательского опыта после установки, корректируя веса текстовых полей.
Иконка, видеоролики и скриншоты напрямую управляют показателем кликабельности (CTR) в выдаче. Высокий CTR конвертируется в установки, формируя позитивный поведенческий сигнал. Бенчмарки 2026 года показывают, что удержание первого дня (D1) выше 35% и седьмого дня (D7) выше 15% считаются маркерами качественного продукта.
Графические элементы напрямую управляют конверсией. Если пользователь увидел продукт в поиске, но не нажал на карточку из-за слабой иконки, алгоритм фиксирует низкий CTR, что со временем снижает позиции по тщательно вписанным ключевым словам.
Видеопревью критически важно для сложных интерфейсов, а скриншоты демонстрируют максимальную эффективность при наличии текстовых оверлеев с УТП. Факторы ранжирования тесно переплетены: видимость приложения и позиции, которые обеспечивают ключевые слова, неразрывно связаны с тем, насколько качественно скриншоты и видео конвертируют показы в целевые действия.
Алгоритм действий ASO-специалиста перед релизом
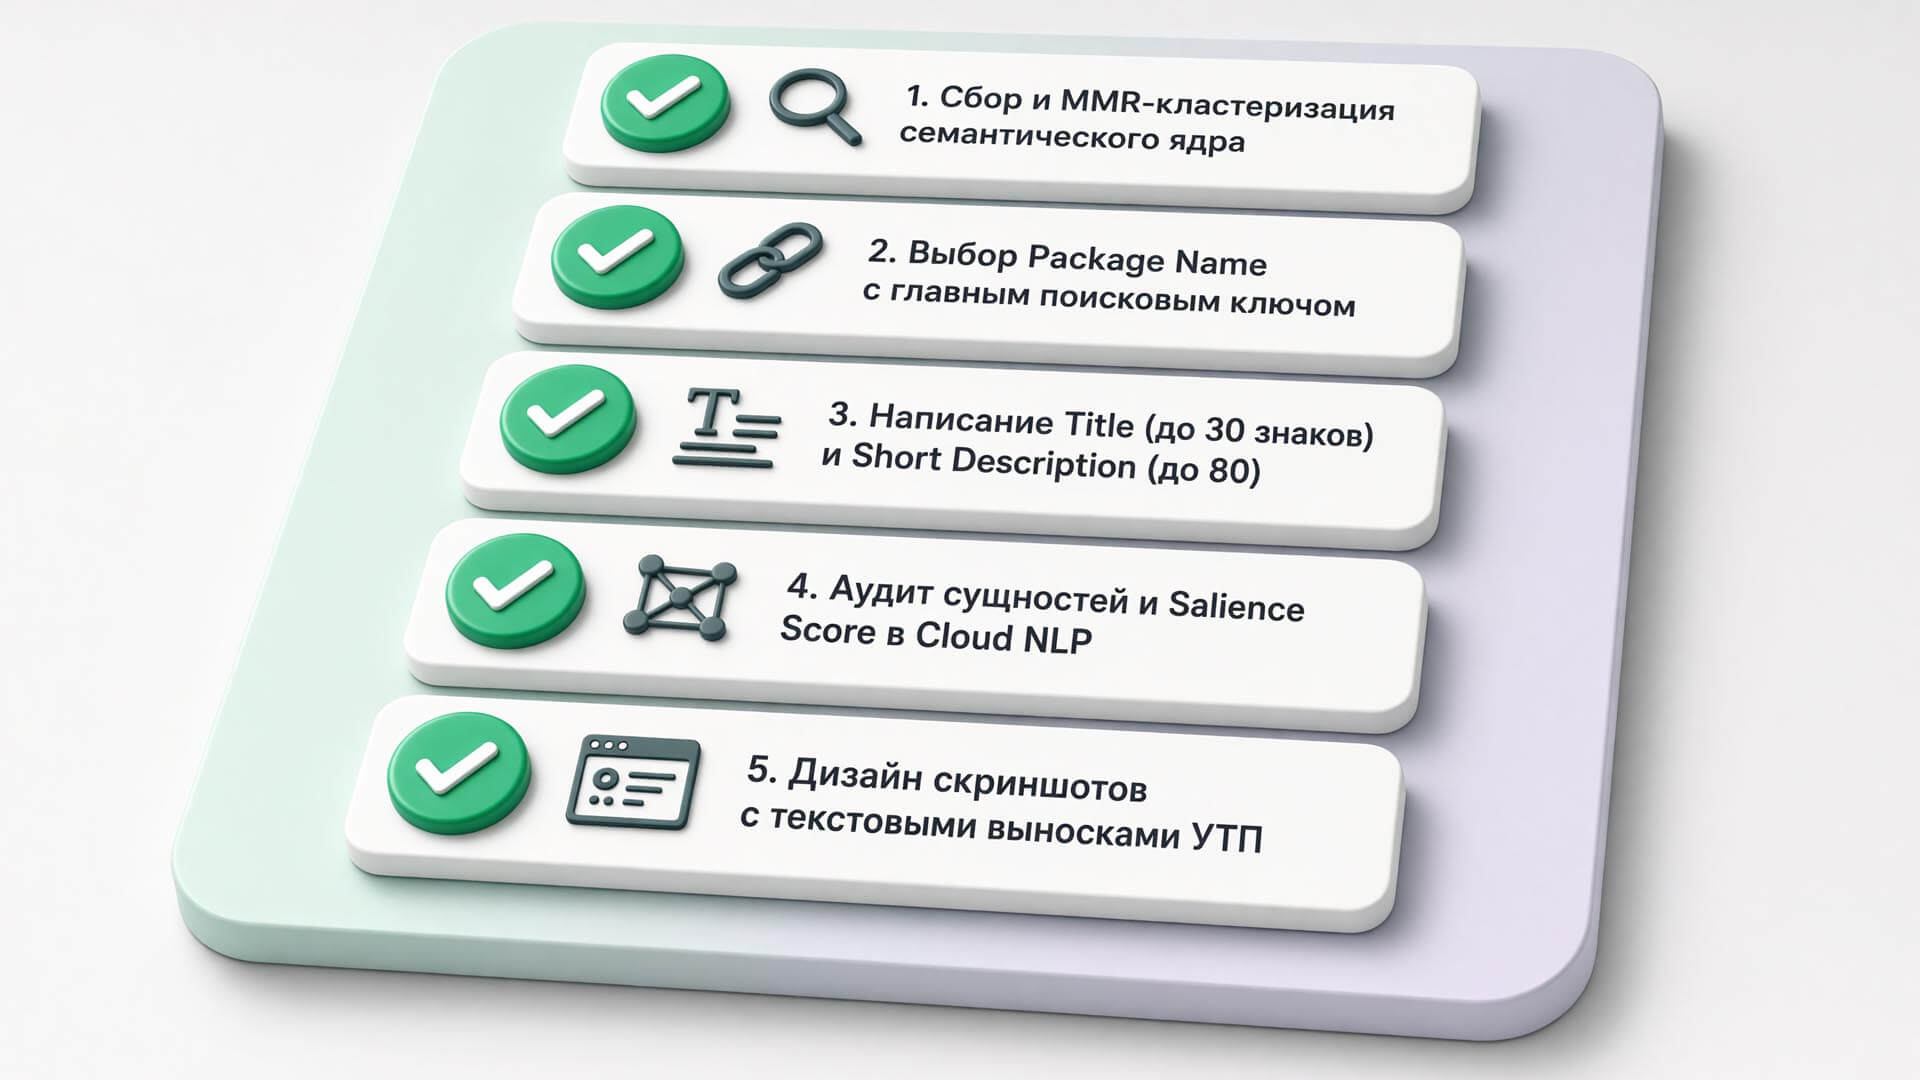
Строгое следование протоколу минимизирует риски пессимизации и гарантирует корректную индексацию метаданных поисковыми роботами:
- Определить целевую аудиторию, сформулировать УТП и выявить основные сценарии поиска.
- Собрать семантическое ядро, включающее высокочастотные и низкочастотные запросы.
- Отфильтровать нерелевантные термины и сгруппировать оставшиеся по интентам.
- Сформировать идентификатор пакета с внедрением главного ключа до создания проекта.
- Написать название, интегрировав бренд и основной запрос без превышения лимитов.
- Заполнить краткое описание по формуле выгоды и призыва к действию.
- Сформировать полный текст, распределив семантику по принципу максимальной маржинальной релевантности.
- Провести аудит контента через облачный API, добившись лидерства целевых сущностей по показателю значимости.
- Сверить готовые метаданные с конкурентами и подготовить локализации под целевые гео.
Данный чек-лист представляет собой исчерпывающий алгоритм. Пошаговая инструкция и практические советы применимы не только перед запуском, но и при регулярных итерациях. Профессиональное ASO требует постоянного мониторинга, так как улучшение видимости в Google Play зависит от адаптации к изменениям поисковых алгоритмов.
Часто задаваемые вопросы (FAQ)
Как алгоритмы в 2026 году обрабатывают длинные запросы?
Поисковая система сместила фокус с коротких точных ключей на анализ пользовательского намерения. Нейросети понимают естественный язык, сопоставляя описательные фразы с графом знаний, что делает низкочастотные запросы приоритетным источником целевого трафика.
Целесообразно ли внедрять длинные фразы в краткое описание?
Лимит в 80 символов не позволяет эффективно размещать длинные конструкции. Данное поле предназначено для одного высокочастотного термина и четкого УТП, тогда как низкочастотную семантику следует органично распределять по абзацам полного текста.
Допустимо ли изменение идентификатора пакета после релиза?
Техническая архитектура платформы исключает такую возможность. Идентификатор фиксируется единожды при создании проекта. Любые корректировки потребуют публикации нового продукта с нулевой историей, потерей базы пользователей и аннулированием рейтингов.
Как верифицировать правильность распознавания тематики текста?
Необходимо отправить контент через метод analyzeEntities облачного API и изучить массив данных. Если целевой термин не занимает лидирующие позиции по метрике Salience, текст корректируется путем перемещения слова в позицию подлежащего первого абзаца.
Требуется ли адаптация контента под ИИ-поиск?
Адаптация строго необходима. Машинный интеллект анализирует карточку на предмет смысловой связности и наличия кластеров сущностей. Структурированный материал, описывающий конкретные сценарии использования, получает приоритет при формировании рекомендательных подборок.
Ответы на эти вопросы формируют базис понимания того, как работает ASO. Описание продукта и package name в Google Play требуют технически выверенного подхода, исключающего интуитивные решения.
Профессиональная помощь с продвижением
Интеграция облачных анализаторов, математический расчет плотности семантики и формирование правильной архитектуры метаданных требуют глубокой экспертизы. Если внутренние ресурсы команды ограничены, делегирование этих задач профильным специалистам гарантирует результат. Комплексное Продвижение приложений в Google Play включает полный цикл работ: от сбора семантического ядра до настройки кастомных страниц. Профессиональные ASO услуги, которые предоставляет агентство, охватывают все этапы: мобильный маркетинг, детальная консультация и стратегия, обеспечивающая стабильный рост органического трафика.
Итоги
Текстовая оптимизация базируется на трех фундаментальных уровнях: неизменяемом идентификаторе пакета, конверсионных метаданных и семантически плотном полном тексте, адаптированном под машинное восприятие.
Ключевые тезисы для внедрения в работу:
- Облачный API анализирует контент идентично поисковому роботу магазина. Аудит метрики Salience до релиза исключает ошибки индексации.
- Идентификатор пакета формируется один раз. Внедренный в него термин генерирует пассивный трафик на протяжении всего срока жизни продукта.
- Распределение семантики по алгоритму MMR предотвращает каннибализацию запросов и расширяет охват низкочастотных фраз.
- Искусственное перенасыщение ключами и использование чужих брендов неминуемо ведут к блокировке аккаунта.
- Поведенческие метрики выступают мультипликатором текстового ранжирования. Без качественной графики позиции по запросам неизбежно снижаются.
Глубокое понимание этих процессов открывает путь к эффективному продвижению приложений в Google Play, где каждая буква метаданных работает на измеримый бизнес-результат.
Комментарии
0