Базовая оптимизация скрытого поля
Правильно настроенное поле keywords в App Store — это скрытый от пользователей массив метаданных в консоли разработчика, который поисковый движок использует исключительно для ранжирования продукта по целевым запросам. Визуально на странице продукта этот блок отсутствует, однако система сканирует его наравне с видимыми текстовыми элементами.
Поисковый движок при ранжировании опирается на три основных текстовых блока. Название (Title) вмещает 30 символов и обладает максимальным весом. Подзаголовок (Subtitle) также ограничен 30 символами и занимает второе место по значимости. Скрытый блок keywords замыкает тройку, предоставляя 100 байт для ввода среднечастотных и низкочастотных фраз, которые не удалось интегрировать в видимую часть. Для латиницы это эквивалентно 100 символам, тогда как для других алфавитов (включая кириллицу и азиатские языки) лимит символов сокращается из-за большего веса знака в байтах. Грамотная настройка этого элемента выступает фундаментом текстовой оптимизации и служит отправной точкой, когда планируется переход к комплексному продвижению приложений в App Store.
Синтаксис и правила заполнения
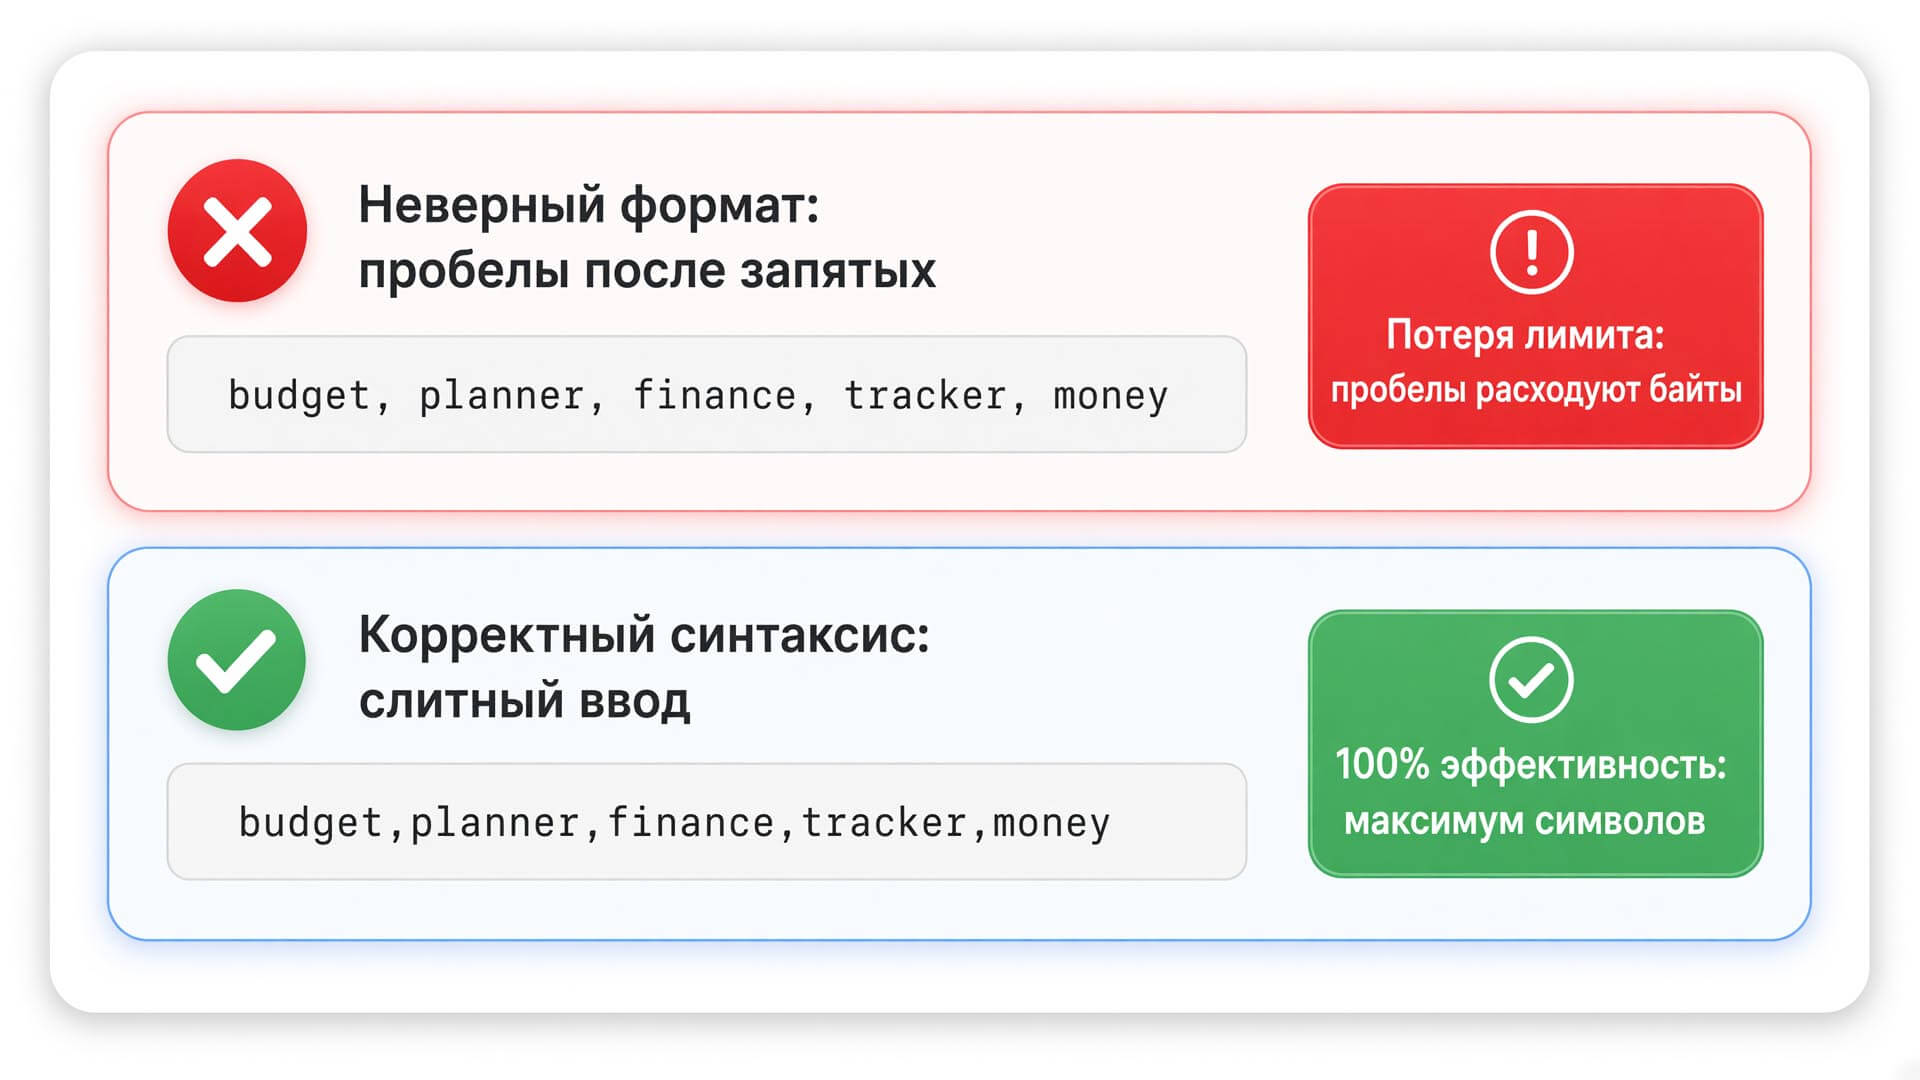
Технический лимит составляет ровно 100 байт. Для латиницы и кириллицы это эквивалентно 100 символам, однако для азиатских языков один иероглиф может занимать больше места. Выполняя заполнение keywords для iOS, необходимо строго соблюдать синтаксис. Термины разделяются исключительно запятыми. Использование пробела после запятой категорически запрещено, так как система воспринимает его как отдельный знак, сокращая полезное пространство.
Базовые принципы форматирования массива:
- Система учитывает только первое вхождение термина, поэтому дублирование лексемы из названия лишает разработчика ценного места.
- Служебные части речи, предлоги и артикли игнорируются поисковым роботом, их добавление нецелесообразно.
- Для английского языка алгоритм автоматически распознает множественное число, достаточно указать форму единственного числа.
- Для других языковых групп автоматическое сопоставление чисел работает нестабильно, требуется ручная проверка выдачи.
- Движок индексирует отдельные лексемы и самостоятельно формирует из них многосоставные поисковые фразы.
Индексация бесплатных запросов
Платформа автоматически присваивает продукту определенный набор лексем, которые не требуют ручного ввода. Эти так называемые скрытые ключи App Store позволяют существенно сэкономить ограниченный лимит в 100 байт. Тратить символы на термины, которые система и так ассоциирует с продуктом, нерационально.
Перечень элементов, индексируемых по умолчанию:
- Базовые категорийные маркеры, включая слова app, free, iphone и ipad.
- Точное название выбранной категории продукта, которое платформа считывает из настроек консоли.
- Все лексемы, уже задействованные в видимых текстовых блоках (Title и Subtitle).
- Официальное наименование компании-разработчика (Developer Name).
Отдельного внимания заслуживает работа с чужими торговыми марками. Вписывать бренды конкурентов прямым текстом запрещено правилами платформы (App Store Review Guidelines, пункты 2.3.7 и 5.2.1). Подобные действия классифицируются как манипуляция поисковой выдачей. Модерация отклоняет такие сборки, а при систематических нарушениях аккаунт разработчика подвергается блокировке.
Механика обхода лимита символов
Кросс-локализация в App Store — это легальный метод расширения семантического ядра путем добавления дополнительных языковых версий в консоли разработчика для одной целевой страны. Данный подход позволяет кратно увеличить объем индексируемых терминов.
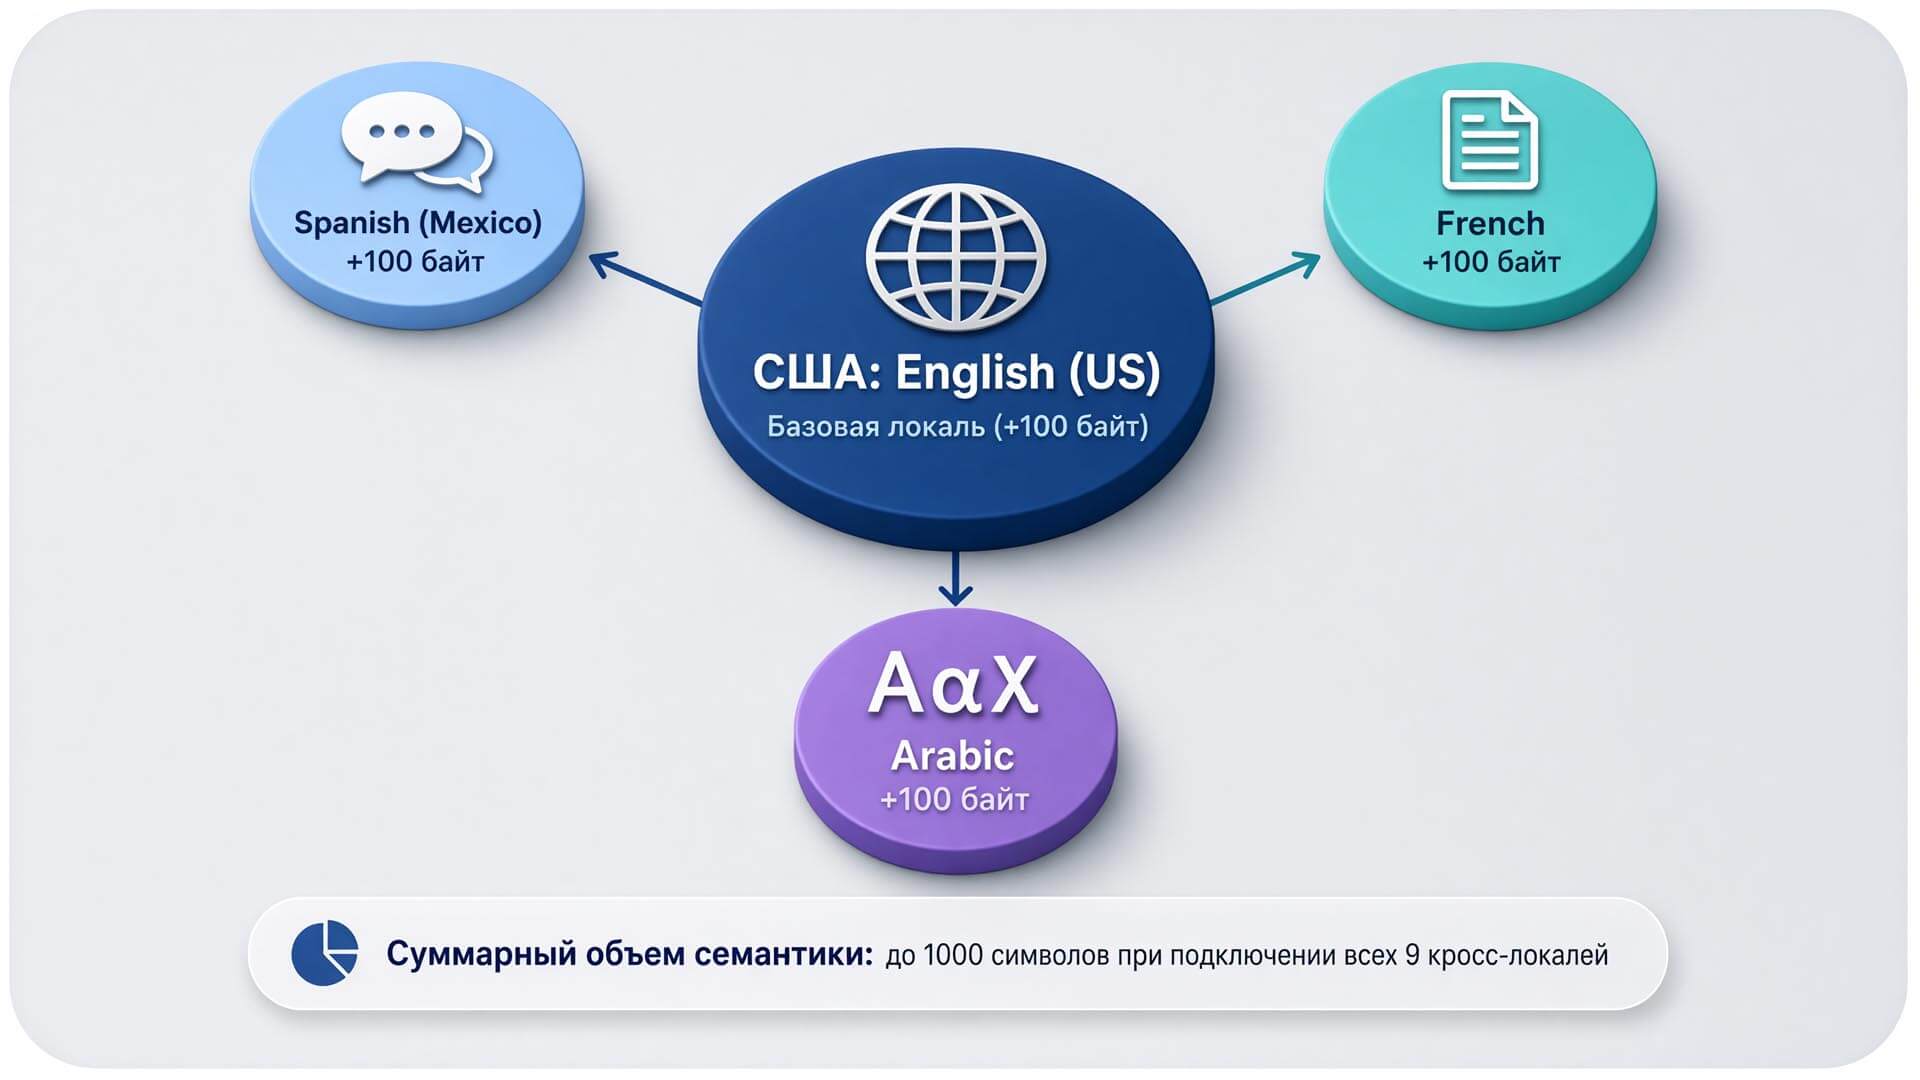
Принцип работы базируется на архитектуре поискового движка. Для конкретного региона платформа позволяет активировать несколько языковых пакетов. Каждый пакет предоставляет независимые 100 байт для ввода терминов. Например, на рынке США система обрабатывает сразу 10 языковых пакетов: основной English (US) и девять вспомогательных. Суммарный объем доступного пространства возрастает со 100 до 1000 символов.
Ключевое ограничение алгоритма заключается в изоляции языковых пакетов. Система формирует составные фразы исключительно внутри одной языковой версии. Лексема из английского пакета не объединяется с лексемой из испанского. Каждая версия обязана представлять собой семантически независимый набор терминов, способный генерировать трафик автономно.
Преимущества двойной локализации
Практика показывает, что двойная локализация App Store решает сразу две задачи: увеличивает плотность терминов и адаптирует продукт под мультикультурную аудиторию. Классический пример — рынок США, где связка English (US) и Spanish (Mexico) охватывает как англоязычных, так и испаноязычных пользователей.
Высокочастотные коммерческие запросы размещаются в основном пакете, получая максимальный приоритет при ранжировании. Вспомогательный пакет заполняется релевантными терминами на втором по популярности языке региона. Это исключает необходимость создания отдельных сборок продукта под разные этнические группы внутри одной страны.
Формирование сложных фраз происходит строго в рамках выбранного языка. Если в подзаголовке испанской версии указано presupuesto, а в скрытом массиве той же версии — planificador, продукт начнет ранжироваться по запросу presupuesto planificador. Перекрестное смешивание терминов между английской и испанской версиями технически невозможно.
Добавление вспомогательных языковых пакетов решает проблему жестких ограничений платформы. На рынке США испаноязычный сегмент генерирует колоссальный объем установок. Игнорирование локали Spanish (Mexico) приводит к потере миллионов потенциальных пользователей, которые формулируют запросы исключительно на родном языке.
Таблица дополнительных языков
Матрица вспомогательных языков жестко привязана к конкретному сторфронту (витрине). Единого стандарта для макрорегионов не существует. В Европе Великобритания опирается на English (UK), Германия — на German, Франция — на French. В Азии Япония использует Japanese, а материковый Китай — Chinese (Simplified).
Дополнительные локали App Store распределены неравномерно. Латинская Америка преимущественно базируется на Spanish (Mexico), при этом ряд стран региона дополнительно считывает English (UK). Рынок США обладает самой широкой матрицей, что делает его идеальным полигоном для тестирования гипотез.
| Страна (целевой рынок) | Базовая локаль | Дополнительные локали (кросс-локали) | Примечание |
|---|---|---|---|
| США | English (US) | Spanish (Mexico), Russian, Chinese (Simplified), Arabic, French, Portuguese (Brazil), Chinese (Traditional), Vietnamese, Korean | Максимальное количество кросс-локалей среди всех рынков — 9 дополнительных |
| Великобритания | English (UK) | Зависит от сторфронта; English (UK) также индексируется в ряде европейских стран без собственной базовой локали | English (UK) часто используется как дополнительная локаль для европейских рынков |
| Германия | German | English (UK) — как дополнительная локаль для расширения охвата | Основной запрос — немецкоязычный; английские ключи расширяют охват на экспатов и туристов |
| Франция | French | English (UK) — как дополнительная локаль | Французский рынок чувствителен к качеству перевода; машинный перевод нежелателен |
| Япония | Japanese | English (US) или English (UK) — как дополнительная локаль | Японские пользователи ищут на японском; английские ключи — для нишевых или глобальных продуктов |
| Корея | Korean | English (US) или English (UK) — как дополнительная локаль | Корейский рынок требует нативной адаптации; прямой перевод снижает конверсию |
| Китай (материковый) | Chinese (Simplified) | Ограниченный набор; дополнительные локали зависят от требований китайского сторфронта | Строгие требования модерации; метаданные должны точно соответствовать функционалу |
| Бразилия | Portuguese (Brazil) | Spanish (Mexico), English (US) — как дополнительные локали | Португальский и испанский охватывают всю Латинскую Америку |
| Мексика и Латинская Америка | Spanish (Mexico) | English (UK) или English (US) — как дополнительные локали | Spanish (Mexico) — базовая локаль для большинства испаноязычных стран региона |
Алгоритм работы с семантикой
Понимание того, как заполнять поле keywords в App Store, требует системного подхода. В текущем году поисковые алгоритмы усилили контроль за релевантностью. Размытые формулировки пессимизируют продукт в выдаче. Система оценивает не просто наличие лексемы, но и ее смысловую связь с категорией и поведением пользователей.
Процесс настройки делится на три этапа: фильтрация дубликатов, распределение массива по языковым пакетам и глубокая культурная адаптация для зарубежных рынков. Использование векторно-эмбеддинговой методологии позволяет кластеризовать запросы по интентам и избежать каннибализации трафика.
Удаление дублей с метаданными
Фундаментальное правило текстовой оптимизации гласит: каждая лексема применяется ровно один раз. Термин, зафиксированный в названии, не требует повторения в скрытом массиве. Система уже проиндексировала его, а дублирование лишь расходует жестко лимитированное пространство.
Порядок фильтрации массива:
- Сбор широкого пула запросов через автоподсказки платформы и аналитические сервисы.
- Выделение лексем, интегрированных в видимые текстовые блоки и название категории.
- Удаление найденных совпадений из общего пула кандидатов.
- Очистка списка от предлогов, союзов и терминов с нулевой частотностью.
- Сортировка остатка по уровню конкуренции для финального ввода.
Распределение ключей по версиям
Логика распределения опирается на частотность. Наиболее конверсионные и популярные запросы интегрируются в название основного языкового пакета. Среднечастотные фразы распределяются между подзаголовком и скрытым массивом основной версии. Узконишевые запросы с длинным хвостом (long-tail) отправляются в скрытые массивы вспомогательных пакетов.
Каждый вспомогательный пакет обязан содержать уникальный набор лексем. Копирование одних и тех же терминов во все доступные версии не дает мультипликативного эффекта. Подобная стратегия ведет к потере потенциального трафика. Дополнительно рекомендуется использовать настройку Custom Product Pages, перенося смысловые акценты из разных языковых пакетов на персонализированные страницы продукта.
Адаптация для зарубежных рынков
Прямая транслитерация или дословный перевод терминов на незнакомый язык — критическая ошибка. Азиатские рынки особенно чувствительны к культурному контексту. Пользователи в Японии или Корее формулируют потребности иначе, чем аудитория в Европе.
Методология работы с иностранными рынками:
- Применение DeepL для перевода европейских языков с сохранением профессиональных глоссариев.
- Использование ChatGPT для генерации контекстных заголовков и адаптации тональности (prompting).
- Отказ от дословного перевода для китайского, японского и корейского языков в пользу локальных идиом.
- Обязательная верификация машинного перевода нативным специалистом для исключения смысловых ошибок.
- Анализ автоподсказок локального сторфронта для выявления реальных пользовательских формулировок.
При выходе на рынки Азии прямой перевод английского семантического ядра разрушает индексацию. Алгоритм начинает показывать продукт по нерелевантным запросам. Культурализация смыслов требует понимания местного менталитета: необходимо найти именно те формулировки, которые органичны для локального пользователя, а не просто перевести слова из словаря.
Продвинутые тактики оптимизации
Специалисты постоянно ищут способы, как расширить семантику в App Store без нарушения правил. Одна из рабочих тактик — разделение сложных составных слов на базовые компоненты. Поскольку движок самостоятельно склеивает лексемы, нет необходимости тратить символы на длинные словосочетания. Освободившееся место заполняется новыми терминами.
Анализ сезонных трендов и автоподсказок позволяет выявлять низкочастотные запросы с минимальной конкуренцией. Внедрение таких терминов дает быстрый прирост органических установок. Дополнительный объем трафика привлекается за счет индексации названий In-App Purchases, так как наименования встроенных покупок также сканируются поисковым роботом.
Критические ошибки при настройке
Технические недочеты при работе с метаданными приводят к пессимизации продукта. Анализ сотен сборок выявляет типичные паттерны ошибок, которые допускают разработчики перед отправкой на ревью.
- Дублирование лексем. Ввод одинаковых терминов в основном и вспомогательном языковых пакетах не дает преимущества. Система засчитывает термин единожды.
- Нарушение синтаксиса. Оставленные пробелы после запятых сокращают полезный объем. Десять пробелов уничтожают 10% доступного пространства.
- Повторение видимых элементов. Копирование слов из названия в скрытый массив расходует лимит впустую.
- Использование брендов. Внедрение чужих торговых марок гарантирует отклонение сборки модераторами платформы.
- Игнорирование контекста. Машинный перевод без культурной адаптации для азиатских рынков приводит к нулевой конверсии из показа в установку.
Финальная проверка перед релизом
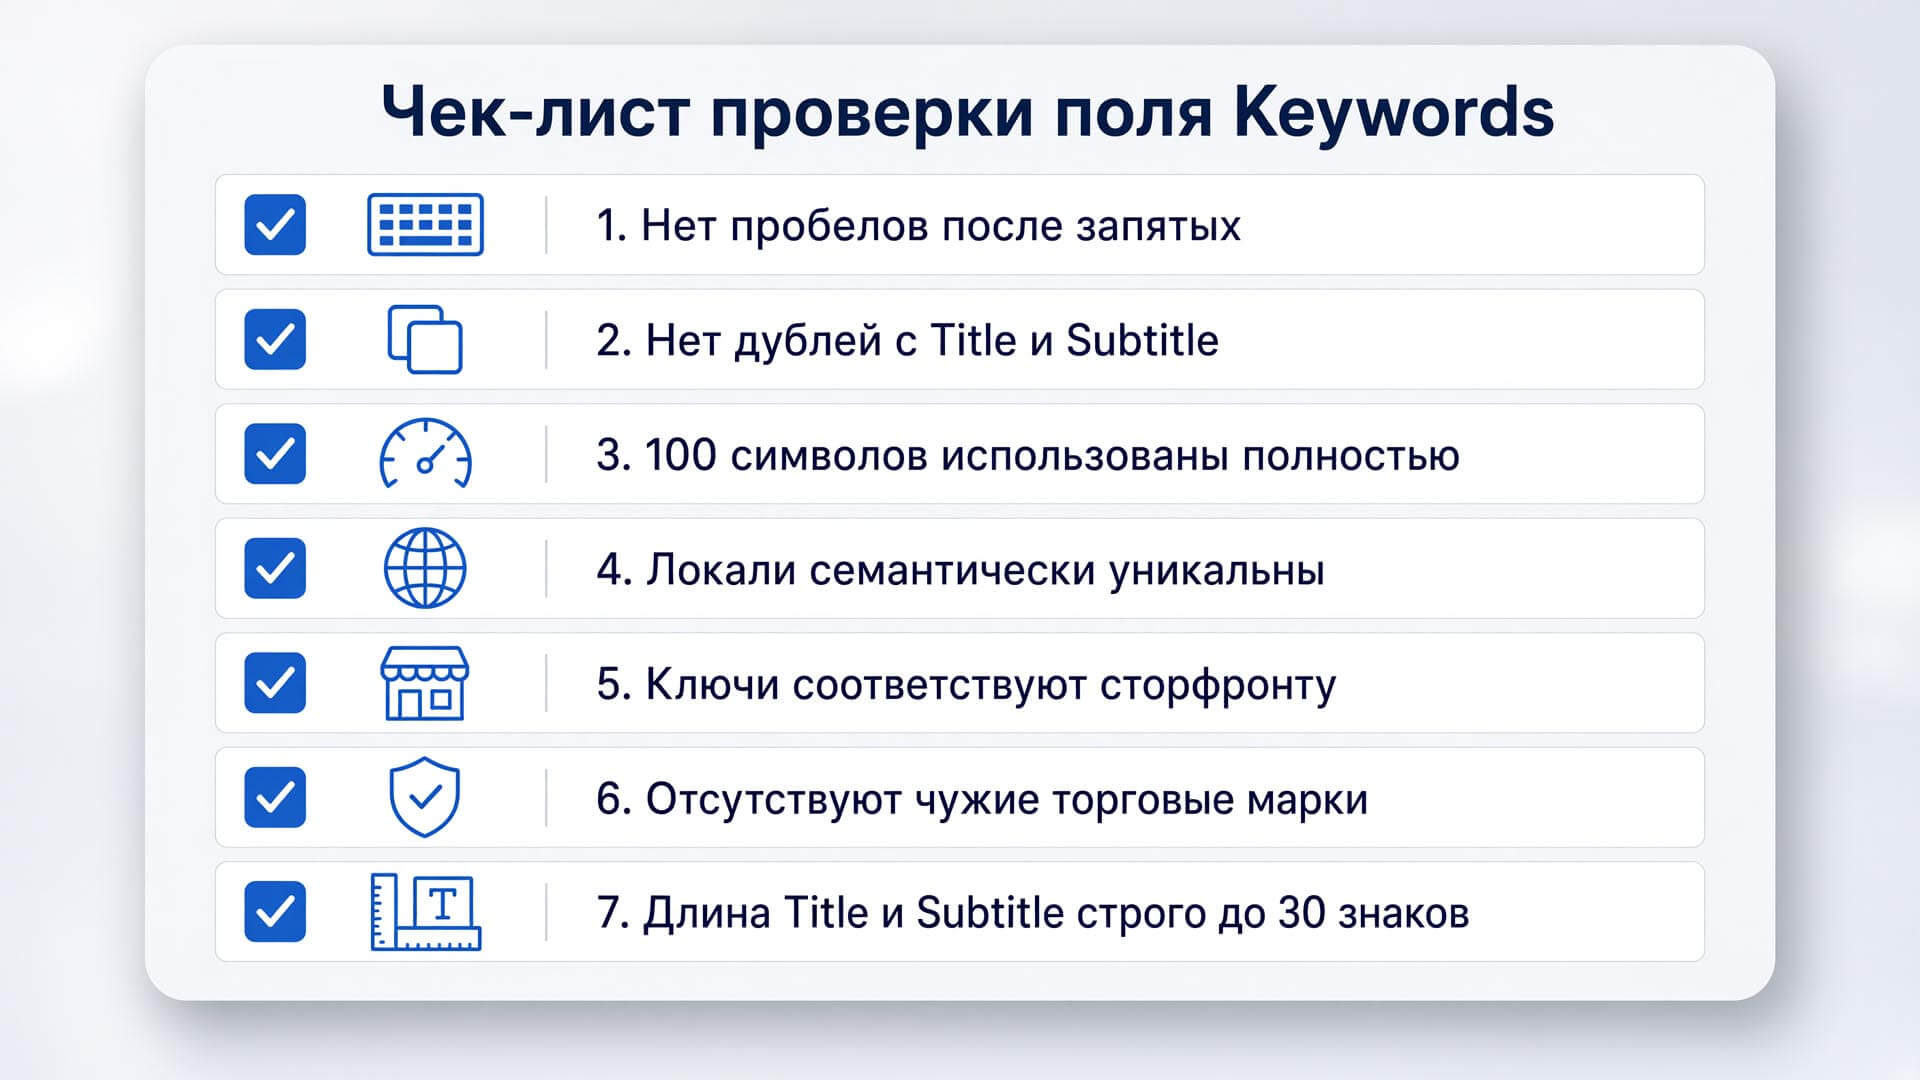
Процедура контроля качества метаданных минимизирует риск отклонения сборки и гарантирует корректную индексацию. Строгое следование чек-листу исключает технические потери трафика.
- Синтаксис проверен: термины разделены запятыми, пробелы полностью отсутствуют.
- Массив очищен от лексем, уже задействованных в названии и подзаголовке.
- Лимит в 100 байт израсходован максимально эффективно, пустых мест не оставлено.
- Каждый вспомогательный языковой пакет содержит уникальный, непересекающийся набор терминов.
- Выбранные пакеты точно соответствуют целевому региону и требованиям сторфронта.
- Массив не содержит названий конкурентов, брендов и запрещенных платформой слов.
- Длина видимых текстовых блоков строго укладывается в лимит 30 символов каждый.
Ответы на частые вопросы
Сколько символов вмещает скрытый массив метаданных?
Техническое ограничение составляет ровно 100 байт. Термины вводятся через запятую без использования пробелов. Любой пробел после запятой распознается системой как отдельный знак и безвозвратно уменьшает доступный объем.
Требуется ли дублировать слова из названия продукта?
Нет. Поисковый робот учитывает каждую лексему только один раз. Термин, зафиксированный в видимых текстовых блоках, уже участвует в ранжировании. Повторное указание не усиливает позиции, а лишь расходует жестко ограниченный лимит.
Как работает добавление вспомогательных языков?
Механика заключается в активации дополнительных языковых пакетов для конкретной страны в консоли разработчика. Каждый пакет предоставляет независимые 100 байт для ввода терминов. Это позволяет охватить больше целевых запросов и адаптировать продукт под мультикультурную аудиторию региона.
Объединяет ли алгоритм термины из разных языковых пакетов?
Нет. Формирование составных поисковых фраз происходит исключительно внутри одного языкового пакета. Лексема из английской версии не комбинируется с лексемой из испанской. Каждая версия индексируется автономно.
Допускается ли использование брендов конкурентов?
Нет. Внедрение чужих торговых марок прямо нарушает правила платформы. Модерация отклоняет такие сборки, требует немедленного исправления метаданных, а при повторных нарушениях блокирует аккаунт разработчика.
Сколько языковых пакетов доступно для рынка США?
Для американского сторфронта предусмотрено 9 вспомогательных пакетов помимо основного English (US). В их число входят Spanish (Mexico), Russian, Chinese (Simplified), Arabic, French, Portuguese (Brazil), Chinese (Traditional), Vietnamese и Korean. Каждый пакет добавляет 100 байт к общему объему.
Итоговые выводы
Грамотная настройка скрытого массива метаданных определяет успех органического роста. Сто байт информации при профессиональном подходе к продвижение приложений в App Store трансформируются в мощный инструмент привлечения целевого трафика. В 2026 году поисковые алгоритмы требуют предельной точности: общие фразы уступают место узкоспециализированным терминам с подтвержденным спросом.
Активация вспомогательных языковых пакетов легально расширяет технические лимиты платформы. На рынке США использование всех доступных версий увеличивает объем индексируемых данных в десять раз. Главное условие — обеспечение семантической уникальности каждого пакета, так как система не формирует межъязыковые комбинации.
Соблюдение базовых правил синтаксиса, исключение дубликатов и отказ от использования чужих брендов гарантируют беспроблемное прохождение модерации. Понимание того, как алгоритмы поиска Apple сканируют и объединяют текстовые элементы, позволяет выстроить долгосрочную стратегию оптимизации, устойчивую к изменениям рыночной конъюнктуры.
Комментарии
0